Paper Info
- Title: Unpacking Failure Modes of Generative Policies: Runtime Monitoring of Consistency and Progress
- Venue: CoRL 2024
- Keywords: Generative Robot Policy, Failure Detection, Runtime Monitoring, Temporal Action Consistency, Vision Language Model, Out-of-Distribution Detection
Summary
최근 Diffusion Policy와 같은 생성형 모방학습(Generative Imitation Learning)은 다양한 human demonstration으로부터 복잡한 로봇 행동을 학습하고, 새로운 환경에서도 일정 수준의 generalization을 보이고 있다. 그러나 실제 배포 환경에서는 물체의 크기·위치·동역학과 같이 학습 중 보지 못한 조건이 지속적으로 나타날 수 있으며, 이러한 Out-of-Distribution(OOD) 상황에서 policy behavior는 예측하기 어려워질 수 있다. 따라서 로봇을 실제 환경에 안정적으로 배포하기 위해서는 policy가 task를 실패하고 있는지를 실행 중에 감지하여 조기에 개입할 수 있는 runtime monitoring이 필요하다.
하지만 generative policy의 failure detection은 일반적인 OOD detection 문제처럼 다루기 어렵다.
1) 로봇의 failure는 하나의 observation이나 action에서 결정되는 것이 아니라 여러 timestep의 closed-loop interaction을 통해 누적되어 발생하며,
2) generative policy는 하나의 상태에서도 여러 정상적인 action mode를 생성할 수 있어 runtime behavior 자체가 다양함.
따라서 현재 observation이 학습 데이터와 다른지, 또는 하나의 action이 평소와 다른지만으로 실제 task failure를 판단하기 어렵다.
기존 runtime failure detection은 크게 두 방향으로 정리할 수 있다.
1) 현재 observation이나 policy output이 nominal distribution과 얼마나 다른지를 측정하는 OOD 기반 접근,
2) symbolic state나 foundation model을 이용해 로봇의 task execution 자체를 관찰하는 외부 monitoring 기반 접근
하지만 두 접근 모두 generative policy의 다양한 failure mode를 하나의 기준으로 안정적으로 처리하기 어렵다.
Observation embedding 기반 방법은 새로운 state를 빠르게 탐지할 수 있지만, 새로운 상황이 곧 failure를 의미하지는 않는다. 물체의 형태나 위치가 학습 데이터와 달라지더라도 policy가 충분히 generalize하면 task를 정상적으로 수행할 수 있기 때문이다. 따라서 state atypicality만으로 failure를 판단하면 successful OOD rollout까지 failure로 잘못 분류할 수 있다.
반면 policy output의 variance나 reconstruction error를 이용하는 방법은 policy behavior를 직접 반영할 수 있지만, generative policy의 action multimodality 때문에 정상적인 행동 다양성과 실제 이상을 구분하기 어렵다. 동일한 상태에서도 여러 개의 올바른 행동 전략이 존재할 수 있으므로 높은 action variance 자체가 failure를 의미하지 않으며, diffusion reconstruction과 같은 일부 방법은 runtime에서 상당한 계산 비용도 요구한다. 논문은 여기서 failure 자체도 하나의 형태로 나타나지 않는다는 점에 주목한다. 어떤 failure에서는 policy가 여러 행동 사이를 반복적으로 오가거나 충돌하는 erratic behavior를 보이는 반면, 다른 경우에는 policy가 매우 일관된 행동을 수행하면서도 task completion에는 전혀 가까워지지 않을 수 있다. 예를 들어 robot이 장애물의 왼쪽과 오른쪽 중 하나를 선택하지 못하고 행동을 반복적으로 변경한다면 빠르게 탐지해야 하는 erratic failure에 해당한다. 반대로 잘못된 위치를 향해 계속 움직이거나 일정한 action을 반복하면서 task progress가 멈추는 경우에는 action 자체는 안정적이므로 temporal inconsistency만으로 탐지하기 어렵다.
즉 기존 방법의 핵심 한계는 다음과 같이 정리할 수 있다.
Generative policy의 failure는 서로 다른 행동 특성을 가지기 때문에, 하나의 OOD 또는 uncertainty score만으로 모든 failure를 탐지하기 어렵고 각 failure mode가 요구하는 탐지 방식과 시간 규모도 서로 다르다.
따라서 논문이 제기하는 핵심 문제는 다음과 같다.
Failure data 없이도 generative policy에서 나타나는 서로 다른 runtime failure를 구분하고, 각 failure 특성에 적합한 detector를 이용하여 안정적으로 탐지할 수 있는가?
논문은 이를 해결하기 위해 Sentinel을 제안한다.
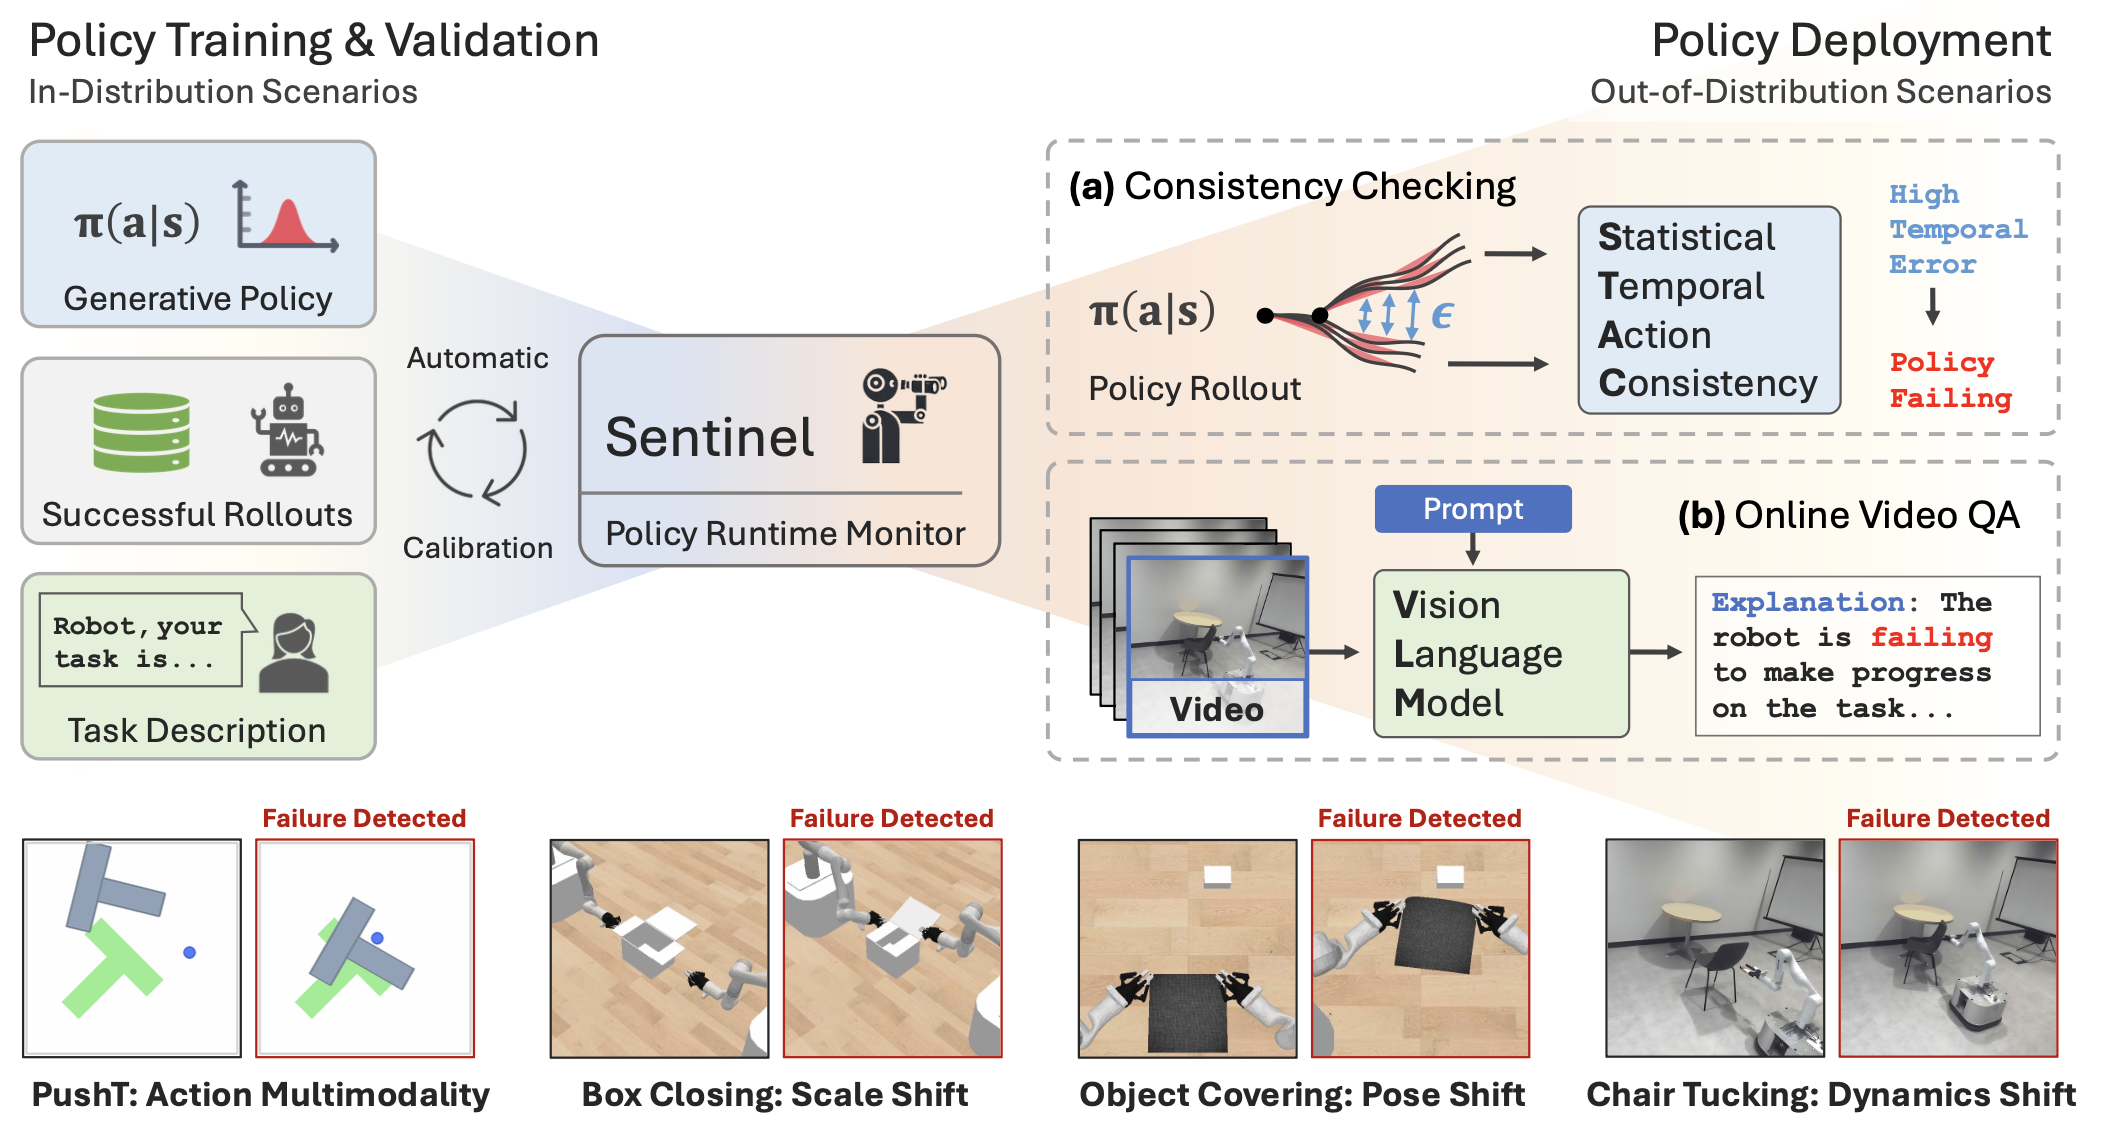
Sentinel은 기존 generative policy를 수정하지 않고 runtime에 추가하는 monitoring framework이며, failure trajectory가 아니라 소수의 successful policy rollout과 task description만을 이용한다. 핵심 아이디어는 모든 failure를 하나의 detector로 처리하는 대신 서로 다른 특성을 가진 두 failure category로 나누고 각각에 적합한 detector를 병렬로 사용하는 것이다.
Sentinel은 failure를 두 가지로 구분한다.
1) Erratic Failure: policy의 action distribution이 시간에 따라 비정상적으로 변화하면서 행동이 흔들리거나 충돌하는 failure,
2) Task Progression Failure: policy action은 시간적으로 일관되지만 잘못된 행동을 지속하면서 task completion에 가까워지지 않는 failure.
Erratic failure는 collision이나 unsafe behavior로 빠르게 이어질 수 있으므로 즉각적인 탐지가 필요하지만, task progression failure는 일정 시간 동안 robot behavior를 관찰해야 판단할 수 있다. 이를 위해 Sentinel은 action 기반 STAC(Statistical Temporal Action Consistency)과 VLM 기반 task progress monitor를 사용한다.
STAC은 개별 action 값이 아니라 연속된 timestep에서 generative policy가 생성한 action distribution의 temporal consistency를 측정한다. Diffusion Policy는 일정 길이의 future action chunk를 생성하고 일부를 실행한 뒤 다시 새로운 action chunk를 생성한다. 이때 이전 timestep과 현재 timestep에서 예측한 future action에는 overlapping 구간이 존재한다. Policy가 정상적으로 동작한다면 이전 시점에서 예상한 future action distribution과 실제 state를 관측한 뒤 다시 생성한 distribution이 크게 다르지 않을 것이라는 것이 기본 가정이다. Generative policy에서는 sampling randomness와 multimodality 때문에 하나의 action끼리 직접 비교하면 정상 상황에서도 큰 차이가 나타날 수 있다. 따라서 STAC은 각 timestep에서 여러 action sequence를 sampling하고, overlapping future action distribution 사이의 차이를 MMD(Maximum Mean Discrepancy)나 KL-divergence와 같은 statistical distance로 측정한다. 계산된 distance를 trajectory를 따라 누적하고, successful rollout으로 calibration한 threshold를 초과하면 erratic failure warning을 발생시킨다.
하지만 policy가 잘못된 action을 일관되게 반복하면 두 시점의 action distribution은 유사하기 때문에 STAC만으로 failure를 탐지하기 어렵다. 이를 보완하기 위해 Sentinel은 VLM 기반 Video QA monitor를 사용한다. 현재까지의 robot image sequence를 video로 입력하고 task description, 현재 경과 시간, task time limit을 함께 제공한다. VLM은 robot과 task-relevant object가 시간에 따라 어떻게 움직였는지를 분석하고, 현재 task가 정상적으로 진행되고 있는지 또는 남은 시간 내 completion이 어려운지를 판단한다.
두 detector는 서로 다른 시간 규모에서 동작한다. STAC은 policy output을 이용하는 통계적 detector이므로 빠르게 실행하여 즉각적인 대응이 필요한 erratic failure를 담당한다. 반면 VLM은 video reasoning으로 인해 latency가 크지만 task progression failure는 상대적으로 긴 시간에 걸쳐 나타나므로 더 낮은 빈도로 실행할 수 있다. 최종 Sentinel은 두 detector를 병렬로 실행하고 어느 하나라도 failure를 판단하면 warning을 발생시키는 Logical OR 방식으로 결합한다.
실험은 PUSHT, CLOSE BOX, COVER OBJECT의 세 simulation task와 실제 PUSH CHAIR task에서 수행한다. Object scale, position, pose 등의 조건을 학습 범위 밖으로 변화시켜 OOD scenario를 만들고, embedding similarity, diffusion reconstruction, DDPM loss, output variance 등의 다양한 failure detector와 비교한다. 또한 action multimodality가 큰 환경, erratic failure가 주로 발생하는 환경, temporally consistent한 task progression failure가 발생하는 환경을 구분하여 두 detector의 역할을 평가한다.
실험 결과 STAC은 multimodal generative policy에서도 erratic failure를 안정적으로 탐지하며, 단순 state similarity 기반 방법보다 successful OOD와 실제 failure를 잘 구분한다. 반면 temporally consistent한 task progression failure에서는 STAC의 탐지 성능이 감소하고 VLM이 이를 보완한다. 두 detector를 결합한 Sentinel은 한 detector만 사용할 때보다 18% 더 많은 failure를 탐지했으며, 실제 Push Chair 환경에서도 95%의 detection accuracy를 기록한다.
결과적으로 Sentinel의 목적은 모든 failure를 하나의 anomaly score로 탐지하는 것이 아니라, generative policy의 failure를 행동 특성에 따라 분리하고 각각에 적합한 runtime signal을 사용하는 것이다.
논문의 기여는 generative policy failure를 erratic failure와 task progression failure로 구분하는 문제 설정, action distribution의 시간적 일관성을 측정하는 STAC, 그리고 VLM 기반 task-progress monitoring을 결합하여 failure data 없이 다양한 unknown failure를 탐지하는 framework로 정리할 수 있다.
Critic
1. Failure Detection과 Failure Prediction의 차이
Sentinel은 failure trajectory를 가능한 이른 시점에 탐지하는 것을 목표로 하지만, 실제 failure가 발생하기 이전의 precursor를 학습하여 미래 failure를 예측하는 구조는 아니다. 논문 역시 limitation에서 failure가 발생하기 전에 예측하는 것이 아니라 발생하는 failure를 탐지하는 데 초점을 둔다고 명시한다. 따라서 early failure prediction과는 구분할 필요가 있다.
2. Action Inconsistency와 Failure의 불완전한 대응
STAC은 action distribution의 temporal inconsistency가 erratic failure와 연결된다고 가정한다. 그러나 환경 변화에 정상적으로 적응하거나 다른 valid action mode로 전환하는 경우에도 distribution이 크게 변할 수 있다. 반대로 policy가 하나의 잘못된 행동을 강하게 선택하면 action consistency는 높지만 failure가 발생할 수 있다.
3. 실제 Physical Response 미활용
STAC은 policy가 생성하는 action distribution의 변화만 사용하며 action을 실행한 뒤 robot이나 environment가 실제로 어떻게 반응했는지는 직접 이용하지 않는다. 따라서 mass, friction, contact, actuator condition과 같은 물리 변화가 발생하더라도 policy output이 계속 일관되면 이상을 놓칠 수 있다. Expected physical response와 actual response의 inconsistency를 직접 모델링하지 않는 한계가 있다.
4. Action Chunk 구조에 대한 의존성
STAC은 이전과 현재 timestep에서 생성한 action chunk의 overlapping future horizon을 비교한다. 따라서 일정 길이의 future action sequence를 반복적으로 생성하는 policy에는 자연스럽지만, single-step policy나 overlapping horizon이 없는 구조에는 그대로 적용하기 어렵다. 실제 ablation에서도 execution horizon의 설정에 따라 detection performance가 달라진다.
5. 반복 Action Sampling의 계산 비용
STAC은 action multimodality를 고려하기 위해 매 timestep마다 여러 action sequence를 sampling하여 distribution을 비교한다. 특히 PushT와 Push Chair에서는 256개의 action sequence를 사용한다. GPU parallelization을 활용하더라도 더 큰 diffusion policy나 높은 control frequency가 필요한 환경에서는 이러한 반복 sampling이 runtime overhead로 이어질 수 있다.
6. Successful Calibration Data에 대한 의존성
Failure trajectory는 필요하지 않지만 threshold 설정을 위해 별도의 successful policy rollout이 필요하다. 또한 성공했더라도 jitter나 부적절한 행동이 포함된 trajectory를 calibration에 사용하면 해당 behavior가 nominal로 간주되어 detector sensitivity가 낮아질 수 있다. Demonstration data를 그대로 사용하는 경우에도 covariate shift로 false positive가 증가하는 문제가 나타난다.
7. VLM의 모델 및 도메인 의존성
VLM의 monitoring 성능은 model과 environment에 따라 크게 달라진다. Close Box에서는 GPT-4o가 상대적으로 안정적이지만 Cover Object에서는 Claude 3.5 Sonnet이 더 높은 성능을 보인다. Simulation image나 unfamiliar camera view에서는 object state와 task progress를 잘못 해석할 수 있으므로 범용 detector라고 보기에는 model capability와 visual domain에 대한 의존성이 크다.
8. 높은 VLM Runtime Latency
논문에서 GPT-4o를 이용한 Video QA의 평균 응답시간은 약 14초이다. 저자는 task progression failure가 상대적으로 느리게 발생하므로 이를 허용할 수 있다고 설명하지만, 짧은 manipulation task나 빠른 failure에서는 warning이 실제 대응에 사용되기에는 늦을 수 있다.
9. 두 Failure Category의 완전성 부족
Sentinel은 failure를 erratic failure와 task progression failure로 구분하지만 저자 역시 두 category가 모든 failure를 포괄한다고 주장하지 않는다. Sensor degradation, actuator fault, grasp instability처럼 현재 behavior는 안정적이고 task progress도 유지되지만 이후 failure로 발전하는 현상은 두 범주 모두에서 명확하게 탐지되지 않을 수 있다.
10. Logical OR 결합의 한계
Sentinel은 두 detector 중 하나라도 failure를 판단하면 warning을 발생시키는 단순 OR 구조를 사용한다. 서로 다른 runtime frequency에서도 쉽게 결합할 수 있지만 각 detector의 false positive가 누적될 수 있다. 논문 역시 전체 Sentinel에 대한 formal guarantee는 제공하지 않으며, detector를 보다 정교하게 결합하는 방식을 future work로 제시한다.
11. Failure 원인 진단의 한계
STAC이 warning을 발생시키면 action inconsistency가 증가했다는 사실은 알 수 있지만, 그 원인이 collision, perception error, contact 변화, actuator 문제 중 무엇인지는 판단하지 못한다. VLM도 task progress에 대한 설명은 가능하지만 실제 physical failure mechanism을 직접 식별하는 것은 아니다. 따라서 failure detection 이후 recovery나 replanning으로 연결하기 위해서는 별도의 diagnosis 과정이 필요하다.